Full-stack debugging com IA: o bug que o log dizia que não existia
O app registrava sucesso e o aquecimento do carro demorava dez minutos. A demonstração do Claude Fable 5.1 cruza relato, telemetria e log para achar a causa.

Paul Gomes
Autor
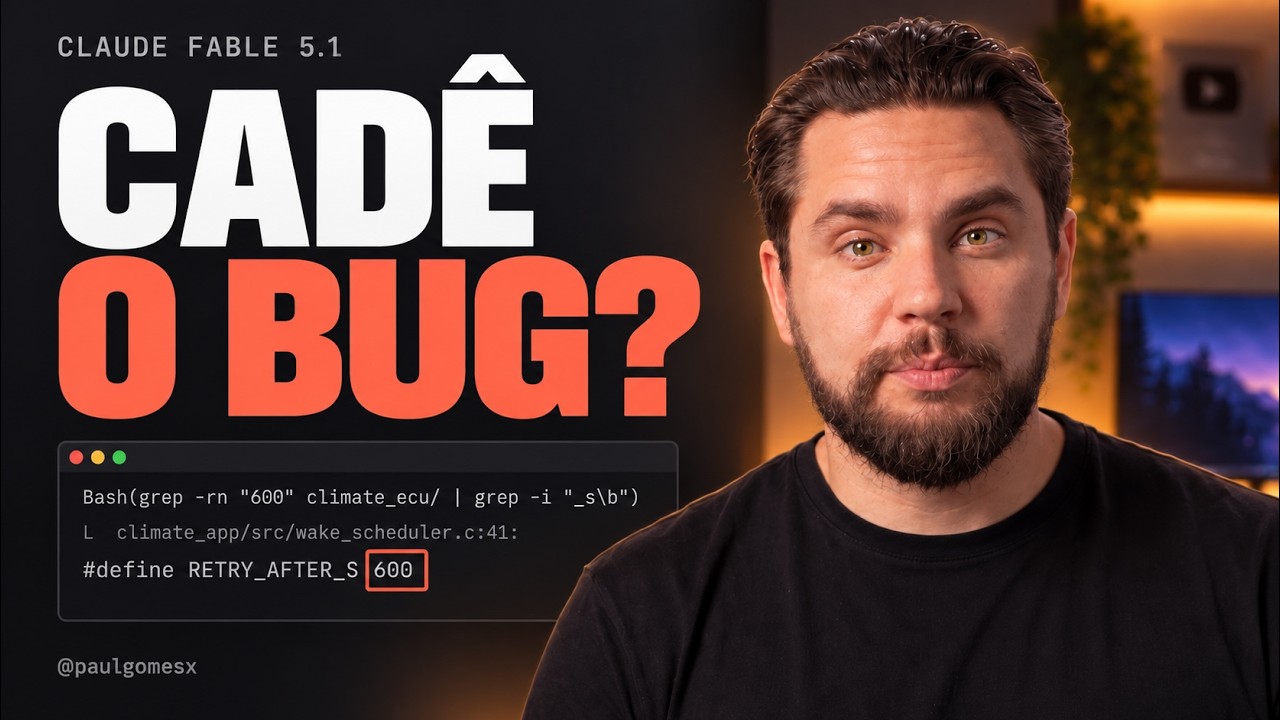
O aplicativo registrava sucesso. O cliente dizia que o aquecimento do carro demorava dez minutos para ligar. Os dois estavam certos — e é exatamente isso que faz dessa classe de bug a mais caras de encontrar.
O bug que não aparece em nenhuma camada
Quando um defeito vive em um lugar só, achar é trabalho de rotina. O erro aparece no log, a exceção tem linha e arquivo, o teste que falha aponta o caminho.
O caso desta demonstração é de outra família. O usuário aciona o aquecimento pelo aplicativo. O aplicativo envia o comando, recebe confirmação e registra sucesso. Do ponto de vista do software, a operação terminou bem. No carro, o aquecimento começa dez minutos depois.
Cada componente cumpriu o próprio contrato. O aplicativo enviou. O serviço aceitou. O veículo, em algum momento, executou. Não há exceção para capturar, porque nada lançou exceção. O log mede se a instrução foi aceita, não se o efeito aconteceu no tempo esperado — e essa distância entre as duas coisas é o espaço onde o problema se esconde.
É a razão pela qual esse tipo de bug costuma viver meses em produção, com tíquetes fechados como não reproduzível.
Onde a evidência estava
A investigação da demonstração cruza três fontes que normalmente ninguém lê juntas.
Os relatos dos clientes. Texto livre, impreciso, em volume. É a única fonte que descreve o sintoma real, e é a que menos se parece com dado estruturado.
Os dados do veículo. Telemetria: estado do sistema, condições no momento do acionamento, o que de fato aconteceu no hardware e quando.
Os registros do aplicativo. A versão do software sobre a mesma história — o que foi enviado, quando, e com qual resposta.
A causa não está em nenhuma das três. Está na interseção: quais relatos coincidem com quais condições de veículo e quais sequências de registro. Encontrar isso exige comparar milhares de linhas de três formatos diferentes procurando uma coincidência que ninguém sabe de antemão qual é.
É um trabalho que uma pessoa faz — e que leva semanas, porque exige sustentar várias hipóteses ao mesmo tempo enquanto varre volume.
A sequência da demonstração
O que a demonstração mostra, com narração em português explicando o que acontece na tela, tem quatro etapas, e a ordem delas é o ponto.
1. A descoberta do padrão. Antes de olhar uma linha de código, o modelo procura a regularidade nos dados. Qual é a condição comum aos casos que falham e ausente nos que funcionam. Essa inversão importa: a tentação humana é abrir o código primeiro e procurar o que parece suspeito. Partir do padrão evita horas investigando um trecho que não tinha nada a ver.
2. A investigação do código. Com o padrão em mão, a leitura do código deixa de ser exploratória e passa a ser dirigida. Já se sabe o que se está procurando, e o caminho se estreita.
3. A proposta de correção. Uma mudança específica, com justificativa ligada ao padrão observado. Não um conselho genérico sobre tratamento de erro.
4. A validação e o resultado no simulador. Esta etapa é a que separa demonstração séria de demonstração de marketing. A correção é exercida contra o cenário original, no simulador, e o resultado é observado. Sem isso, o que existe é uma hipótese bem escrita.
O que isso diz sobre usar IA para depurar
Duas conclusões, e elas apontam para lados diferentes.
A primeira é que a correlação entre fontes heterogêneas é, hoje, o lugar onde a IA rende mais em engenharia. Não escrever código novo — essa é a parte que mais aparece em demonstração e menos dói no dia a dia. O que dói é entender por que algo se comporta de um jeito que ninguém projetou, com a evidência espalhada em sistemas que não conversam. É trabalho de leitura em volume e de manutenção de hipóteses simultâneas, e é justamente aí que a máquina tem vantagem estrutural sobre a nossa atenção.
A segunda é que nada disso dispensa a validação, e a demonstração acerta em mostrá-la. Uma hipótese articulada com segurança e uma hipótese correta se parecem muito. A diferença entre as duas só aparece quando alguém reproduz o cenário e confere o resultado — e quem assina a correção continua sendo responsável por ela.
A pergunta que deixo é a mesma do vídeo: você usaria IA para investigar um bug assim? Minha resposta é sim, com a ressalva de que eu uso para chegar mais rápido à hipótese certa, não para pular a parte de provar que ela é certa.
Para contexto sobre os modelos usados aqui, escrevi sobre o que a Anthropic lançou com o Claude Fable 5 e o Mythos 5. Se o seu interesse é como montar um agente que executa esse tipo de investigação com etapas e aprovação, o caminho é o loop de planejamento. E se a sua equipe de engenharia está decidindo onde IA entra no fluxo de desenvolvimento sem virar risco, é o tipo de trabalho que conduzo em consultoria de inteligência artificial — o contato é o caminho direto.