
IA
Como os dados de teste podem influenciar um modelo antes da avaliação
No scikit-learn, até o cálculo de uma média pode antecipar informação da amostra reservada. A ordem das operações ajuda a preservar o teste.

Paul Gomes
1 min de leitura
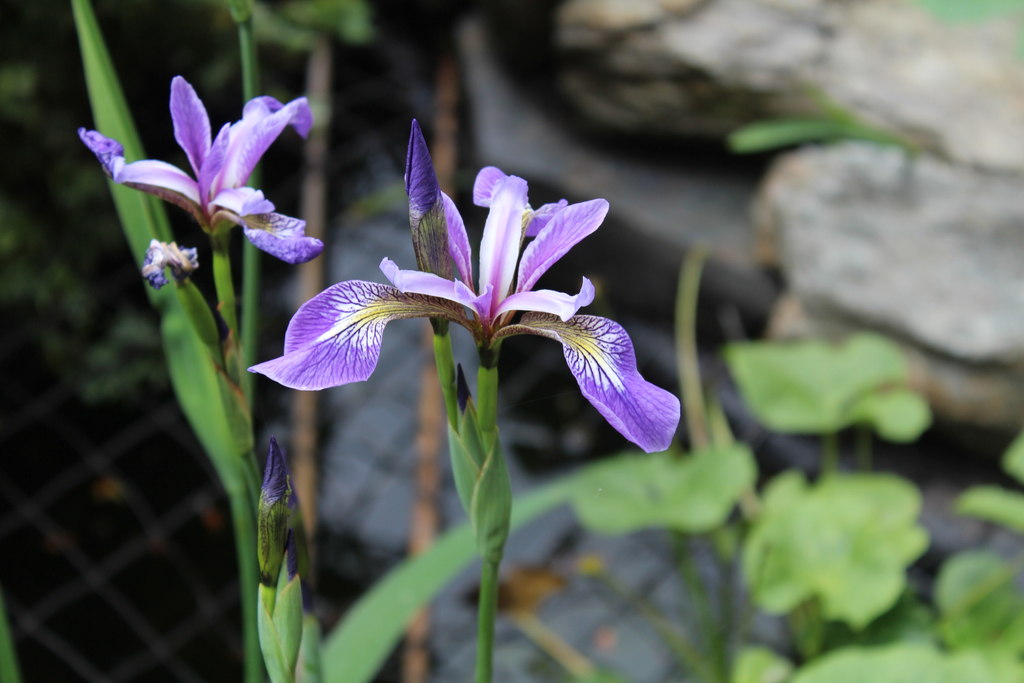
Imagine um classificador que identifica flores pelas medidas de suas pétalas e sépalas, como as do conjunto Iris, distribuído pelo scikit-learn. Antes de treinar, a equipe decide colocar todas as medidas em uma escala comum. Se calcular a média com a coleção inteira, as flores que deveriam ficar reservadas para a avaliação já terão influenciado o modelo, mesmo sem revelar suas espécies.
Esse é um exemplo de vazamento de dados na avaliação. O conjunto de teste representa os casos novos que a aplicação encontrará depois. Segundo a documentação do scikit-learn, a separação precisa acontecer antes de qualquer etapa que aprenda algo da amostra, inclusive o ajuste de escala ou a escolha das variáveis.
Com o StandardScaler, a equipe calcula os parâmetros usando somente os dados de treino. Depois aplica a mesma transformação às observações do teste, sem recalcular a média com elas. Um Pipeline reúne as etapas e ajuda a manter essa ordem em cada divisão da validação cruzada. Ao revisar uma pontuação inesperadamente boa, vale localizar onde ocorreu o primeiro cálculo sobre a coleção inteira.
Foto de capa, ilustrativa. Flor de Iris versicolor, espécie presente no conjunto de dados de classificação Iris. Crédito: Blue flag iris (Iris versicolor) by Richard Hoare. Ficha da fotografia. CC BY-SA 2.0.

Fontes utilizadas
Quem escreve
Paul Gomes
Fundador da WYS. Escrevo sobre marcas, tecnologia e o futuro dos negócios.
Sobre o autorPróximo passo
Quer aplicar isso no seu negócio?
Consultoria de inteligência artificial, GEO/AEO e palestras. Atendimento online, para todo o Brasil.